00 · Attention 基础:从 Q/K/V 到 KV cache¶
本章的两个子章——Attention 机制 与 FlashAttention——讨论的都是「标准 attention 之后」的问题:前者研究定义本身可以怎么改,后者研究定义给定时怎么在硬件上算得快。它们默认读者已经能随手写出 scaled dot-product attention,并且知道 decode 阶段的 KV cache 是什么。这一篇把这块地基补齐:从「attention 到底在算什么」的直觉讲起,把 \(Q, K, V\)、softmax、multi-head、causal mask、KV cache 逐个推一遍,最后算一笔复杂度账。读完这一篇,后文里「\([N, N]\) 中间矩阵」「每 token cache 是 \(2 h_{kv} d_h\) 个元素」这类说法就都有了出处。
1. attention 在做什么¶
一个 token 的向量表示,如果只由它自己决定,就永远无法区分「苹果吃了他」和「他吃了苹果」——语义在上下文里。所以每一层都要做一次信息混合:用全序列的信息更新每个 token 的表示。问题是怎么混合。卷积的做法是固定窗口加权,权重只由相对位置决定;RNN 的做法是从左到右逐词递推,远处的信息要先穿过漫长的状态链。attention 给出了第三种答案:混合权重不由位置决定,而由内容决定——每个 token 根据自己的内容去查询全序列,算出它应该从每个 token 那里取多少信息,然后把取来的信息加权求和。权重是数据依赖的、每个样本都不一样,这正是 attention 表达力的来源,也是它后面一切工程麻烦的来源。
2. Q、K、V 三种角色¶
设输入是 \(N\) 个 token 的表示 \(X \in [N, d]\)。attention 先对同一个 \(X\) 做三次不同的线性投影,得到三组向量:
三个矩阵 \(W_Q, W_K, W_V\) 都是可学习参数。同一个 token 由此扮演三种角色:它的 query 是它提出的问题(「我需要什么样的信息」);它的 key 是它挂出来的索引(「我这里有什么,值不值得被你取」);它的 value 是真正会被取走的内容。匹配发生在 query 和 key 之间,搬运的是 value——匹配标准和搬运内容分开参数化,是这个设计里最容易被忽视、也最关键的一点。
3. scaled dot-product attention¶
单个 head 的 attention 就三步:
逐步看。第一步用点积度量匹配程度:\(S_{ij} = q_i \cdot k_j / \sqrt{d_k}\) 表示第 \(i\) 个 query 和第 \(j\) 个 key 的匹配分。除以 \(\sqrt{d_k}\) 是为了数值稳定:若 \(q, k\) 的分量近似独立、零均值、单位方差,则点积的方差正比于 \(d_k\);\(d_k\) 取 64 或 128 时,未缩放的打分动辄十几,softmax 会被推到接近 one-hot 的饱和区,梯度随之消失。除以 \(\sqrt{d_k}\) 把打分的方差拉回 1 附近。
第二步沿 \(S\) 的行方向做 softmax:
于是每一行都是一个和为 1 的概率分布——第 \(i\) 个 token 决定「把注意力分给全序列」的方案。
第三步按权重混合 value:\(O = PV\),即
第 \(i\) 行输出只由第 \(i\) 个 query 和全部 KV 决定,这正是后面 FlashAttention 能按行块切分计算的数学基础。三个矩阵的 shape 值得记住,本章所有关于显存与 IO 的讨论都建立在它们之上:
| 量 | shape | 说明 |
|---|---|---|
| \(Q, K, V\) | \([N, d_k]\) / \([N, d_k]\) / \([N, d_v]\) | 每行一个 token |
| \(S, P\) | \([N, N]\) | 随序列长度平方增长 |
| \(O\) | \([N, d_v]\) | 与输入同形状 |
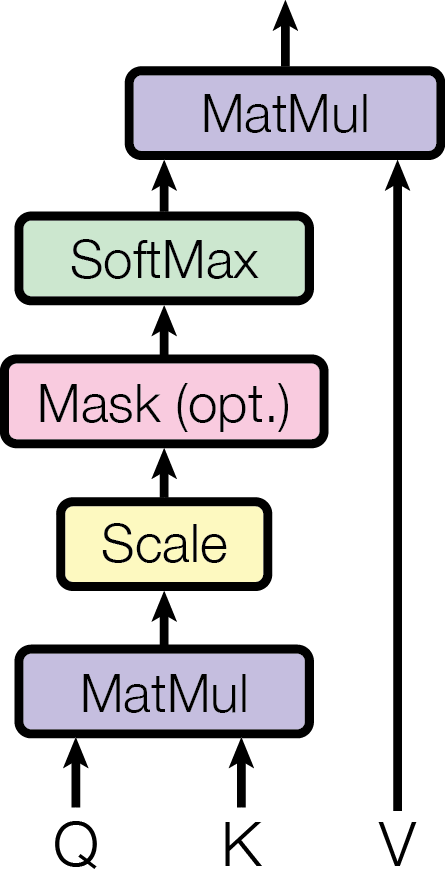
图:scaled dot-product attention 的数据流。注意 Mask 是可选的——decoder-only 语言模型里它就是下一节的 causal mask。(Vaswani et al. 2017, Fig 2 左;arXiv:1706.03762)
4. multi-head attention¶
直接做一次 \(d\) 维的 attention 有一个结构性限制:每个 token 只有一行 softmax 分布,也就是只能用一种方式混合全序列。但依赖关系不止一种——语法近邻、指代、语义搭配可能需要不同的取法。multi-head attention 的做法是把 \(d\) 维切成 \(h\) 份,每份独立做一次完整的 attention:
每个 head 的维度 \(d_h = d / h\)(\(d_k = d_v = d_h\)),\(h\) 个 head 各自学出一套 \(W_i^Q, W_i^K, W_i^V\),可以在不同的表示子空间里捕捉不同的依赖;最后把 \(h\) 个 \([N, d_h]\) 的输出拼回 \([N, d]\),再经 \(W_O\) 混合一次。由于维度被均分,总计算量与单头 \(d\) 维 attention 大致相同,多出来的只是 \(h\) 行独立的概率分布。工程上 \(Q, K, V\) 通常存成 \([N, h, d_h]\) 一个张量,head 维只是多出来的一根轴——后文说的「\(S, P\) 是 \([N, N]\)」严格说是 per head 的,总中间量还要乘 \(h\)。
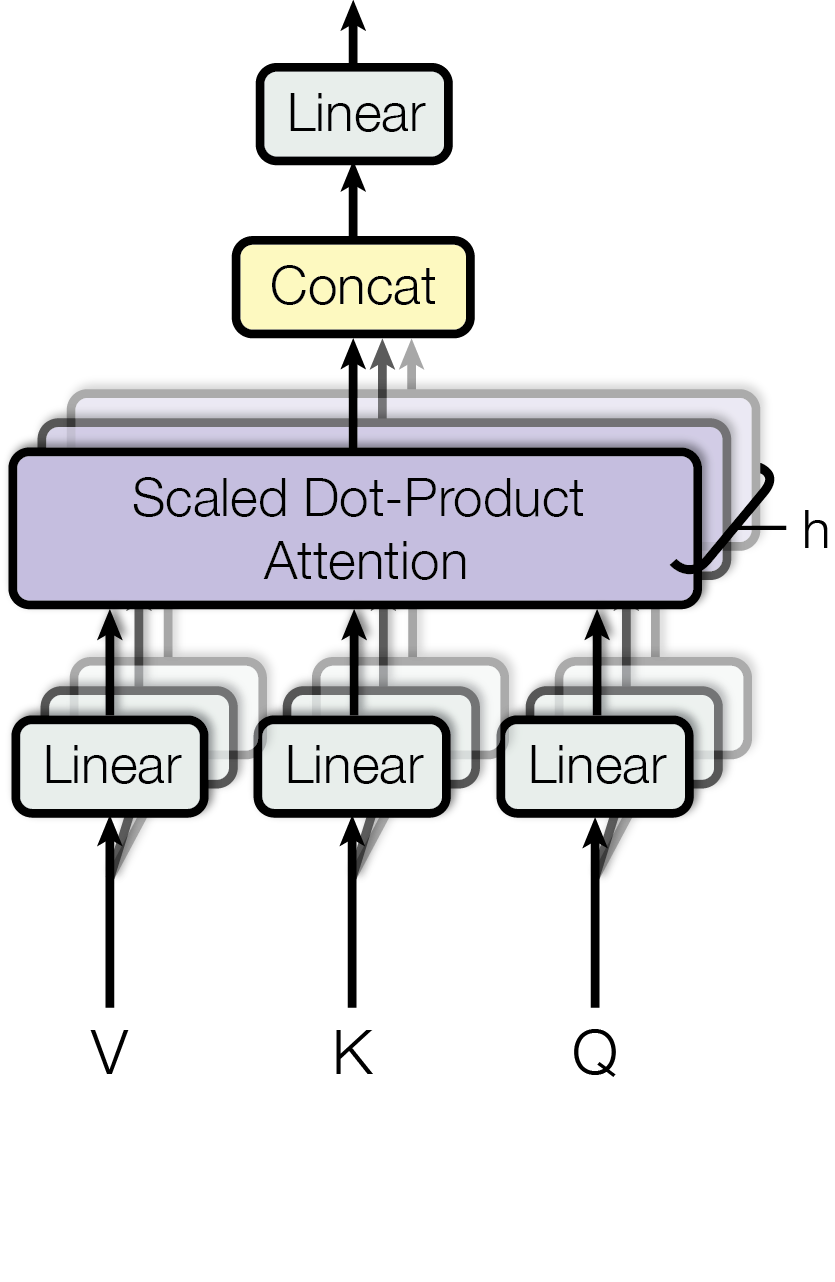
图:multi-head attention。三个 Linear 把 \(d\) 维投影并切成 \(h\) 份(实现上是一次投影加 reshape),\(h\) 个 scaled dot-product attention 并行,Concat 后接输出投影 \(W_O\)。(Vaswani et al. 2017, Fig 2 右;arXiv:1706.03762)
5. causal mask¶
训练是并行做的:整段序列一次送进模型,\(S\) 的每个元素 \(S_{ij}\) 都会被算出来。但语言模型的目标是「用前 \(i\) 个 token 预测第 \(i+1\) 个」,如果第 \(i\) 行能看到 \(j > i\) 的位置,答案就泄漏了。causal mask 把 \(S\) 的严格上三角置为 \(-\infty\),softmax 之后这些位置的概率精确为 0:
每一行只 attend 到自己及之前的位置。decoder-only 模型(GPT 系、Llama 系,本书讨论的几乎所有模型)全部使用 causal mask。它带来两个结构性后果,后面会反复用到:一是有效计算量恰好是满矩阵的一半;二是第 \(i\) 行的计算量随 \(i\) 线性增长——把序列切成两段时,后半段的行天然比前半段「重」,Context Parallelism 的负载均衡问题正是从这里来的(见 CP 章 的 zigzag 一节)。
6. prefill、decode 与 KV cache¶
上面的写法是「一次算完 \(N\) 个 token」,对应训练,也对应推理的 prefill 阶段(处理 prompt)。推理的 decode 阶段是另一种形态:自回归地逐 token 生成,每步只多出一个新 token。
关键观察是:生成第 \(t+1\) 个 token 时,需要的只是新 token 的一行 query \(q_t\),以及全部历史的 \(k_1, \dots, k_t\) 和 \(v_1, \dots, v_t\)。历史的 \(K, V\) 在之前的步里已经算过、且不会再变,重算一遍纯属浪费——于是把它们缓存起来,每步只做一次 \([1, d_k] \times [d_k, t]\) 的匹配和一次加权求和。这份缓存就是 KV cache:每生成一个 token,每层追加一行 K、一行 V,每层每 token 占 \(2 h_{kv} d_h\) 个元素(\(h_{kv}\) 是 KV head 数,MQA/GQA/MLA 改的就是这个因子)。
decode 的瓶颈因此和 prefill 完全不同。每生成一个 token,计算量只有 \(O(Nd)\),但要把整个 KV cache 从 HBM 读一遍,访存量是 \(O(N)\) 乘以层数——arithmetic intensity 极低,decode 是彻底的 memory-bound。llama-3-70B 级别的模型在 128K 上下文里,仅读 cache 每步就要搬几十 GB(具体算法见 Attention 机制 第 1 节)。「decode 是 memory-bound」这个结论在本章会被当作公理使用。
7. 一笔复杂度账¶
把上面各节的结论收拢成一张表(per layer,\(N\) 为序列长):
| 量 | 随 \(N\) 的增长 | 出处 |
|---|---|---|
| prefill attention 的 FLOPs | \(O(N^2 d)\) | \(QK^{\top}\) 与 \(PV\) 两个 matmul |
| 中间矩阵 \(S, P\) | \(O(N^2)\) 元素 | §3 的 shape 表 |
| decode 每 token 计算 | \(O(Nd)\) | 一行 query 对全部 KV |
| decode 每 token 访存 | \(O(N)\)(读全 cache) | §6 |
| KV cache 总量 | \(2 h_{kv} d_h \cdot N\),逐层累积 | §6 |
坏消息集中在两处:随 \(N\) 平方增长的中间量与计算,以及随 \(N\) 线性增长、每步都要全量重读的 cache。这两个坏消息分别对应本章的两条线索——FlashAttention 不改定义,用 tiling 和 online softmax 让 \([N, N]\) 中间量不落 HBM,把 kernel 侧的访存压到 \(O(N)\);Attention 机制 则改动定义本身,从「每个 token 要缓存多少个数」和「每步要读多少历史」两个方向压缩 cache。回到 本章 README 可以看到这两条线索的全景图。