Context Parallelism (CP)¶
本章讨论 Context Parallelism(CP):当序列长度增长到单卡无法容纳时,如何把 sequence 维切到多张卡上,并保证 attention 在序列被切开的情况下仍然算对、通信与计算能够 overlap。本文先给出一个统一抽象——Q-KV 二部任务图(attention pool),把 Ring 与 Ulysses 两大算法家族以及后续的负载均衡工作纳入同一框架;之后的 01/02 两篇分别深入两者,03 以负载均衡为线索调研长上下文训练(变长序列)下的一批工作,04 落到 Megatron 的工程实现;算法依赖的定义与公式会在正文中完整给出。
前置知识¶
- 熟悉 self-attention 的 Q/K/V 计算与 softmax;可先读 Attention 基础。
- 了解 TP 的基本通信方式,见 Tensor Parallelism (TP) 与 Sequence Parallelism (SP)。
1. 为什么需要 CP¶
TP 切 hidden、PP 切层、DP 切 batch,但三者都没有切 sequence。当 context 从 4K 增长到 128K 甚至 1M 时,会出现两个问题:
- activation 显存随 \(s\) 线性增长:每层要保存 \([s, b, h]\) 的若干份激活,\(s\) 大到一定程度后单卡放不下。SP 能把它降到 \(1/\mathrm{TP}\),但 TP 通常只有 8,并不够。
- attention 的算力和显存随 \(s^2\) 增长:\(QK^{\top}\) 是 \([s, s]\),FlashAttention 把显存压到 \(O(s)\),但算力仍是 \(O(s^2)\)。单卡计算 1M token 的 attention 既慢,中间量也可能放不下。
CP 的思路是把 sequence 维 \(s\) 切到 \(\mathrm{cp}\) 张卡,每卡只持有 \(s/\mathrm{cp}\) 个 token 的 Q/K/V 和激活。难点在于 attention 是全局的:第 i 个 token 要 attend 到所有 ≤ i 的 token(causal),而那些 token 的 K/V 分散在其它卡上。因此 CP 的全部工程设计都在回答同一个问题:
序列被切开后,如何让每个 query 拿到它需要的所有 KV,同时不把通信变成瓶颈、不让显存退回 \(O(s^2)\)?
Ring 与 Ulysses 给出了两种不同的答案。不过在进入具体算法之前,值得先把这个问题抽象成一张统一的任务图——Ring 与 Ulysses 都只是这张图上的具体调度。
2. 统一抽象:Q-KV 二部任务图¶
本节给出一个能把全章串起来的抽象。后面会看到,Ring、Ulysses 以及 03 篇的全部负载均衡工作,都可以纳入同一个对象——一张 Q-KV 二部任务图——之上的不同调度方案。
2.1 任务图与 attention pool¶
固定一个 attention head。把 query 序列切成 \(n_q\) 个 Q block,KV 序列切成 \(n_k\) 个 KV segment:
attention mask 决定哪些 block 对之间需要计算,定义边集:
\((\mathcal{Q},\mathcal{K},E)\) 构成一张二部图。不同的 mask 只是这张图的不同形态:full attention 是完全二部图;causal 是「下三角」图,\(Q_i\) 只连 \(j\le i\) 的边;sliding window 和 packed 序列的 block-diagonal mask(§5)则是更稀疏的图——稀疏 mask 下大量根本不存在的计算,在图这一层就被天然剔除了。
flowchart LR
    subgraph QB["Q blocks"]
        q0["Q0"]
        q1["Q1"]
        q2["Q2"]
        q3["Q3"]
    end
    subgraph KVB["KV segments"]
        k0["K0,V0"]
        k1["K1,V1"]
        k2["K2,V2"]
        k3["K3,V3"]
    end
    q0 --> k0
    q1 --> k0
    q1 --> k1
    q2 --> k0
    q2 --> k1
    q2 --> k2
    q3 --> k0
    q3 --> k1
    q3 --> k2
    q3 --> k3
图:causal mask 下的 Q-KV 二部任务图(4 块示例)。每条边是一个独立的 tile-attention 任务;任务总数随 Q block 的位置递增,这正是 causal 负载不均的来源(§4)。
每条边 \((i,j)\) 是一个独立的 tile-attention 任务,产出一份可归约的 partial state:
其中 \(L_{ij}\) 是局部 LSE(log-sum-exp),即 \(Q_iK_j^{\top}/\sqrt{d}\) 经 mask 后按行的 log-sum-exp,每个 query 行一个标量;\(O_{ij}\) 是只在该 KV segment 内归一化的局部输出。每个任务只依赖自己那条边的数据,任务之间没有任何顺序依赖,因此可以把整张图看做一个 attention pool:一个可以随意切分、随意放置、随时归约的 tile 任务池。
2.2 partial state 的归约¶
softmax 的分母是全局量,但 log-sum-exp 具有良好的归约结构。对同一个 \(Q_i\),把所有连到它的边的 partial state 合并只需要两步:
第一步把各 tile 的局部 LSE 合并成全局 LSE;第二步按权重 \(\exp(L_{ij}-L_i)\) 对局部输出加权求和——直觉上,每个 tile 的贡献正比于它占全局 softmax 分母的份额。把这个合并记为算子 \(\oplus\),则每个 Q block 的最终输出为:
关键在于 \(\oplus\) 满足结合律与交换律(浮点舍入除外):归约可以按任意顺序、任意分组、在任何一台设备上进行,结果不变。这个归约其实并不新鲜——FlashAttention 的 online softmax 是它的 streaming 形态(running state \((m,l,O)\) 逐块吸收新 tile,01 第 1 节会完整给出);推理侧 FlashDecoding 的 split-KV combine kernel 是它的 tree-reduce 形态。CP 的全部自由度正来源于此:pool 里的任务可以任意调度,最后总能用 \(\oplus\) 拼回正确结果。
2.3 Ring 与 Ulysses 是这张图上的静态调度¶
有了任务图,「选哪个 CP 算法」就变成了一个调度问题:把池中的任务分配到各 rank,并决定 Q、KV 与 partial state 谁移动、谁不动。三类典型策略:
- Q 不动、KV 流动(ring 家族)。每个 rank 固定持有若干 Q block,KV segment 沿环逐站轮转,每到达一块就把它的 partial state 就地 \(\oplus\) 进本地 running state。归约点放在 Q 的属主,归约本身零通信,代价是 KV 要转满一圈;all-gather KV 是它的退化形态(一把拉齐全部 KV)。Ring Attention(01)建立在这一策略上。
- KV 不动、Q 流动。反过来把 Q block 派发到 KV 所在的 rank,算完把 partial state 送回 Q 的属主做 \(\oplus\) 归约。KV 不移动意味着 backward 的 \(dK/dV\) 也留在本地,代价是 forward 多一趟 output 的返程通信。推理侧的 FlashDecoding 就是这个策略的单机版本;训练侧 Libra TAP 的 tile 放置(03 第 3.2 节)在 tile 粒度上混合使用策略 1 与 2——优先把 tile 放到「KV 已驻留」或「Q 的属主」rank 上,正是对这两种数据移动成本的权衡。
- head repartition(Ulysses)。换一个维度:attention 在 head 维上天然独立,整张二部图可以按 head 切成若干同构的子图,每张子图(完整序列、\(h/\mathrm{cp}\) 个 head)整体交给一个 rank 在本地算完,归约也全部发生在本地。这相当于 \(n_q=n_k=1\) 的退化调度——每卡只算一条边,但这条边覆盖完整序列;两次 all-to-all 只是进出这一 layout 的搬运费。Ulysses(02)即此策略。
Megatron 的 a2a+p2p 分层 CP 则是策略组合:node 内用策略 3(a2a 延迟低),node 间用策略 1(ring 可 overlap),按带宽层级各取所长(02 第 4 节)。
2.4 负载均衡是这张图上的划分问题¶
调度的成本模型很简单:边 \((i,j)\) 的计算量正比于 \(|Q_i|\cdot|KV_j|\),负载均衡就是给每个 rank 分一个子图,使各子图的边权总和相等。全章遇到的所有均衡方案都是对这句话的具体化:
- causal 图的边权随 \(i\) 递增,朴素按 seq 切必然失衡;zigzag / striped 是给这张「下三角」图设计的静态均衡划分(§4,01 第 4 节)。
- 按 head 切(策略 3)切出的子图完全同构,边权天然相等,无需任何修正(02 第 3 节)。
- packed 变长序列的边权不再规则(工作量正比于各文档长度的平方和,§5),静态划分失效,03 篇的一批工作因此把调度做成动态的:Libra TAP 逐个放置图中的 tile,DCP 则更进一步,把「data block + computation block + placement 求解」明确写成框架——可以说 DCP 就是把本节这张图的调度问题原样交给了求解器(TAP 与 DCP 均在 03 第 3.2 节);MagiAttention 则用贪心求解器决定 chunk 到 rank 的任意置换,把 zigzag 的固定配对推广为逐 case 求解(03 第 4.4 节)。
接下来的 §3 先按传统视角并排对比 Ring 与 Ulysses 两个家族,01/02 再分别深入。
3. Ring 与 Ulysses 两种算法¶
flowchart TB
    subgraph RING["Ring Attention (cp_comm_type=p2p)"]
        direction LR
        r0["rank0: Q0,K0,V0"] -->|P2P 传 KV| r1["rank1: Q1,K1,V1"]
        r1 -->|P2P 传 KV| r2["rank2"] --> r3["rank3"] -->|环| r0
    end
    subgraph ULY["Ulysses (cp_comm_type=a2a)"]
        direction LR
        u0["seq 切: 每卡 s/cp token, 全部 head"] -->|all-to-all| u1["head 切: 每卡 全部 token, h/cp head"]
        u1 -->|本地算完整 attention| u2["all-to-all 切回 seq"]
end| 维度 | Ring (p2p) |
Ulysses (a2a) |
|---|---|---|
| 核心操作 | KV chunk 沿环 P2P 传递,每步算一块 attention,online softmax 累加 | 两次 all-to-all:把「seq 切」转成「head 切」,本地算完整 attention,再切回 |
| 通信量/卡 | \(O(s/\mathrm{cp} \cdot \mathrm{cp}) = O(s)\)(每卡转一圈 KV),但可与 compute overlap | \(O(s \cdot h/\mathrm{cp})\)(两次 a2a),不可 overlap,但延迟低、次数少 |
| 通信模式 | P2P(ring),async,能藏进 attention 计算 | all-to-all,集合通信,同步 |
| head 数约束 | 无 | CP ≤ num_heads(要按 head 切,且要整除) |
| 计算复杂度 | 全 flash-attention,\(O(s^2/\mathrm{cp})\) /卡 | 本地完整 attention \(O(s^2)\)/卡(但只在 \(h/\mathrm{cp}\) 个 head 上) |
| 适合 | 超长序列、CP 很大、跨机 | 中等序列、CP ≤ heads、对延迟敏感 |
| 论文 | Ring Attention arXiv:2310.01889 | DeepSpeed-Ulysses arXiv:2309.14509 |
一句话概括:Ring 搬动 KV、保留 head(适合任意 head 数和超长序列);Ulysses 搬动 head、保留完整 KV(实现简单、延迟低,但 CP 不能超过 head 数)。Megatron 还提供 a2a+p2p 分层模式:node 内用 a2a(NVLink 带宽高),node 间用 p2p ring(跨 IB),兼顾两者长处(详见 02 第 4 节)。
两种算法的原始示意图放在一起看最为直观:
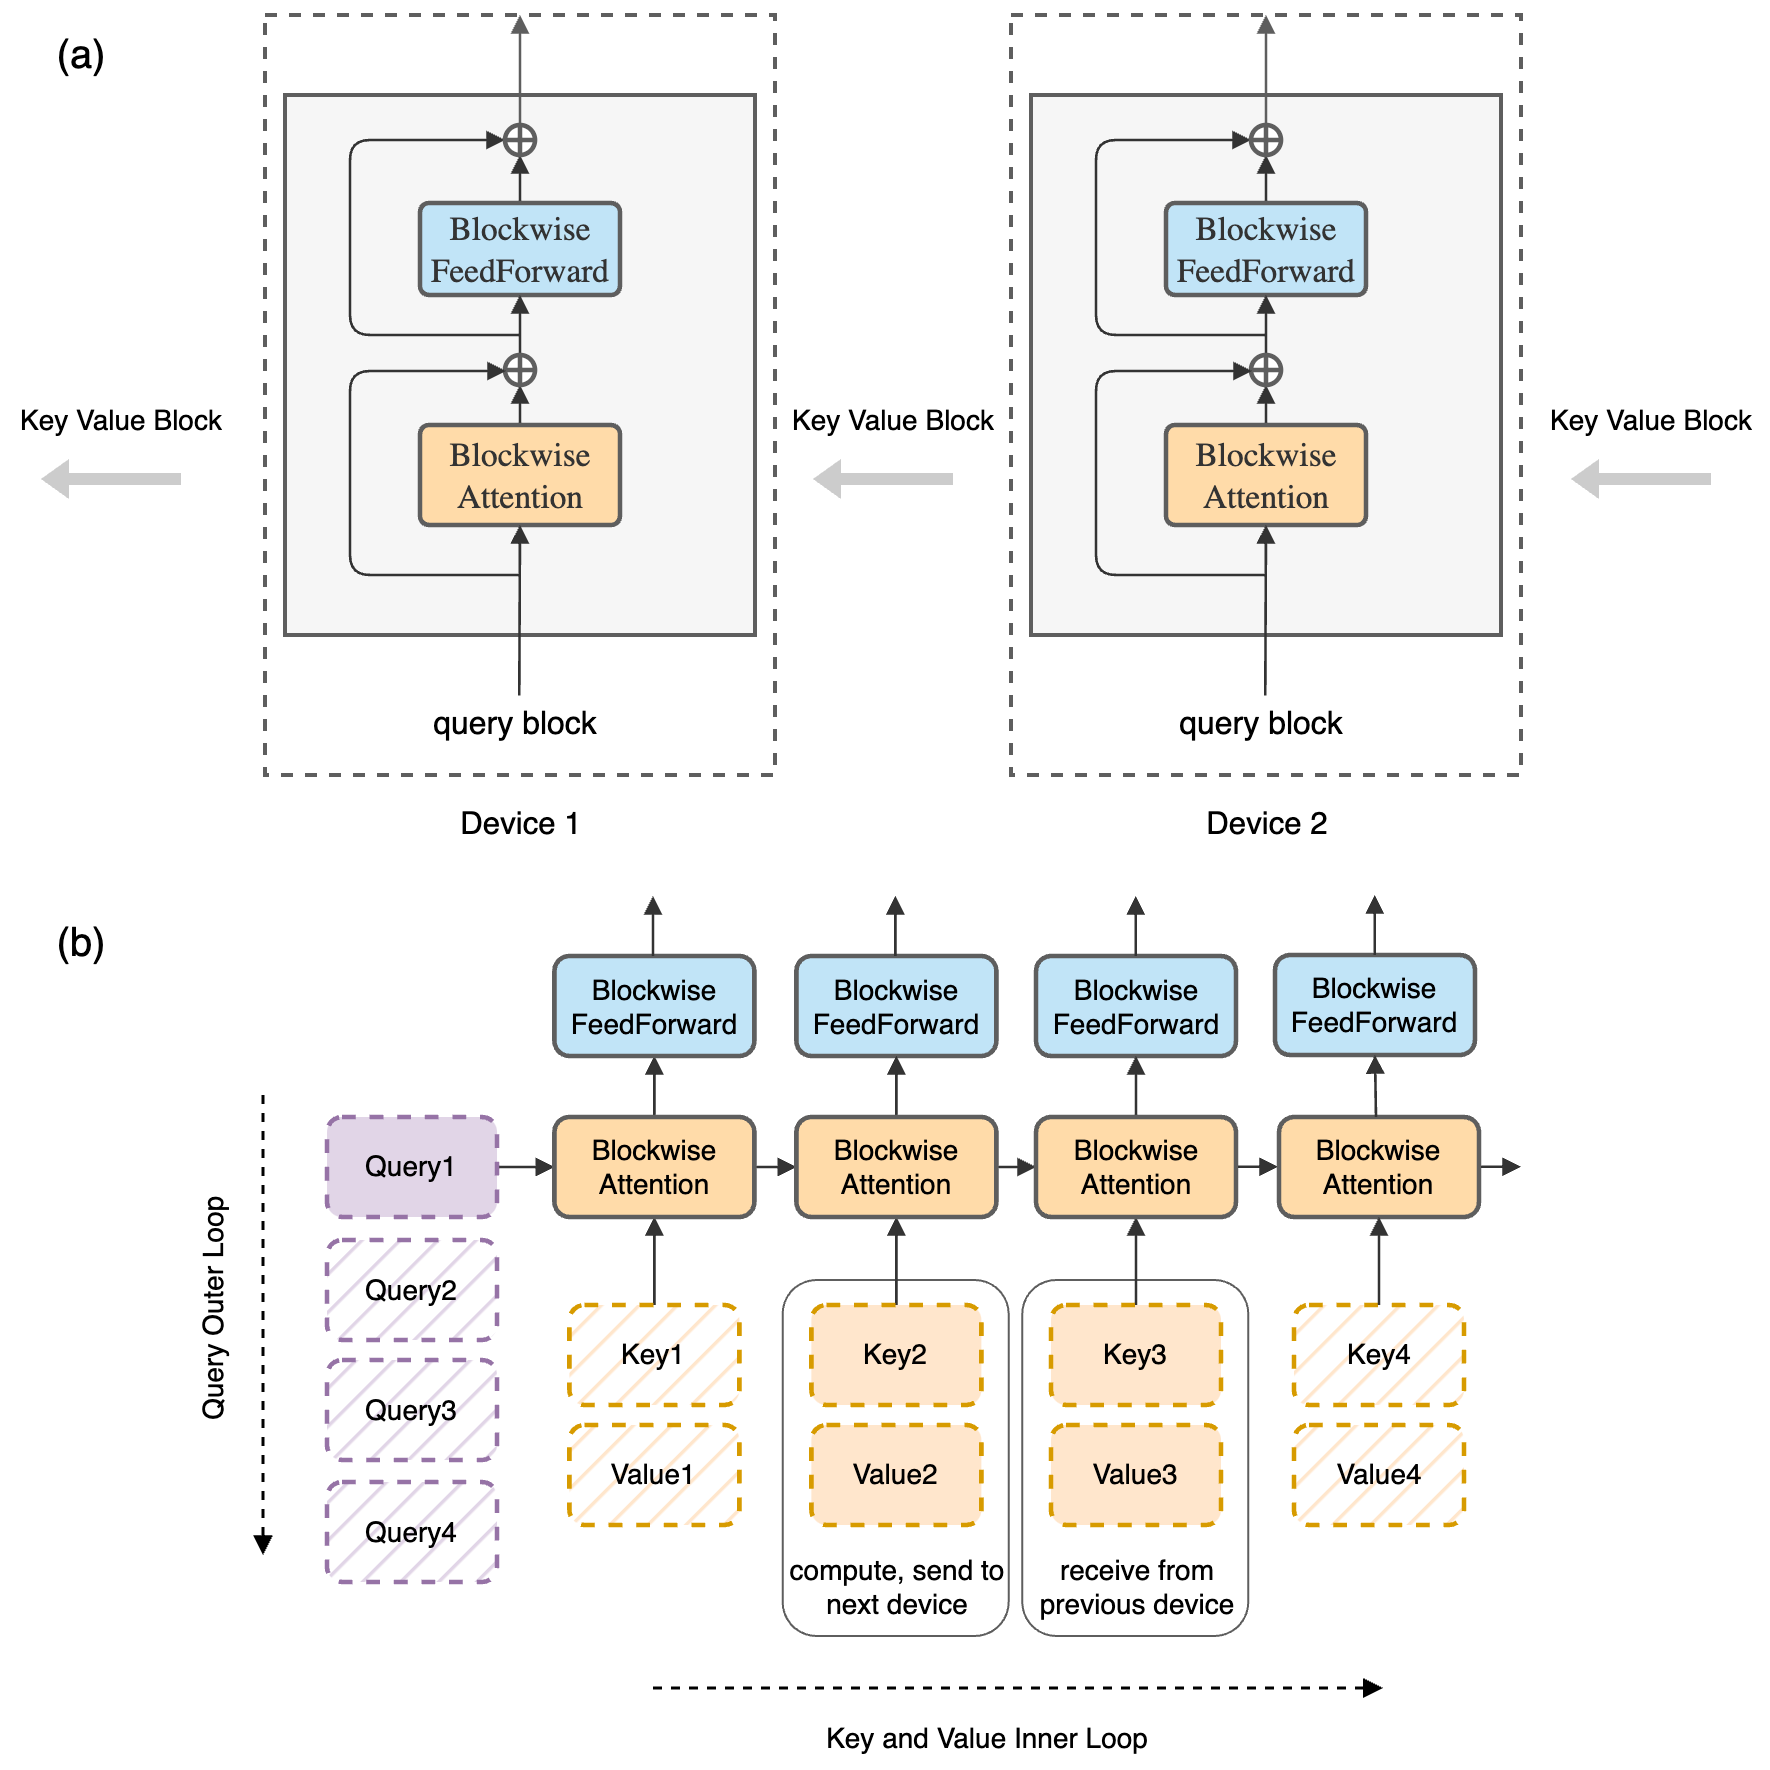
图(Ring):每个 host 固定持有自己那块 query,KV 块沿主机环逐跳传递;每收到一块就用 blockwise/online-softmax 累加一次 attention,转一圈即见过全部 KV。通信(KV P2P)与计算(blockwise attention)天然重叠。(Liu et al. 2023, Fig 2;arXiv:2310.01889)
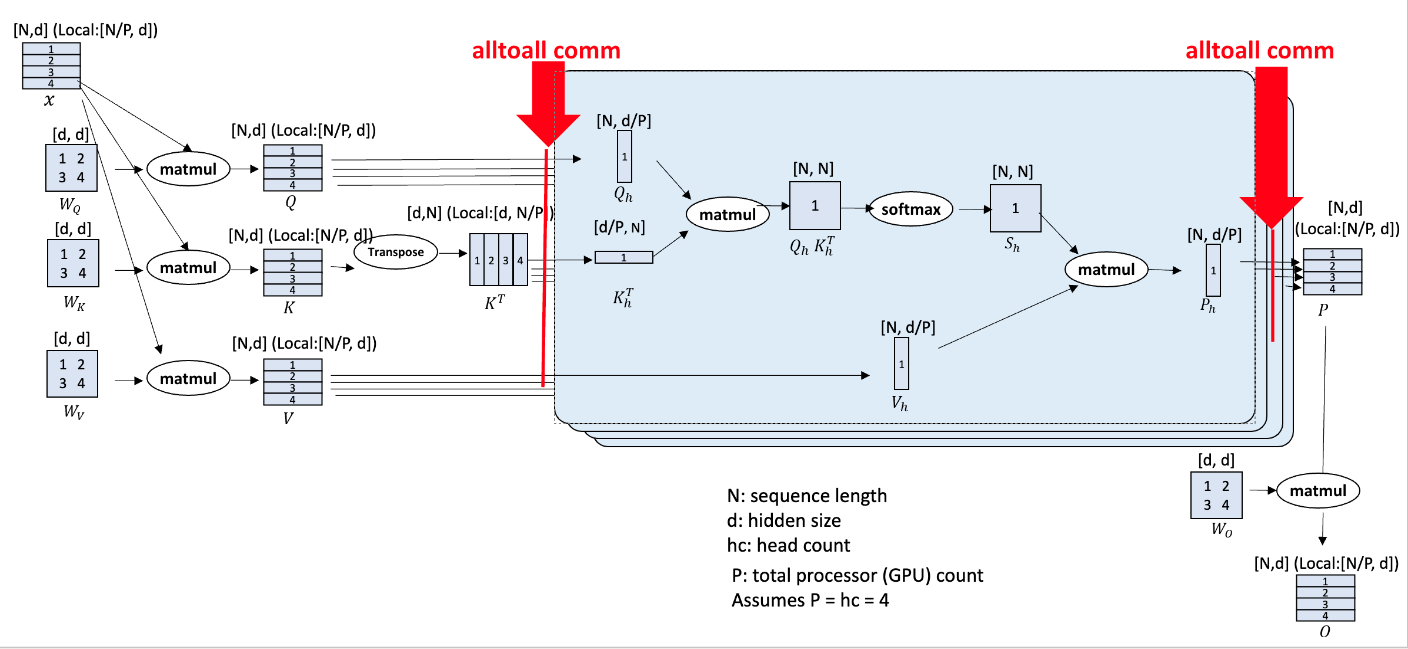
图(Ulysses):QKV projection 阶段按 sequence 切(每卡 \(s/\mathrm{cp}\) token、全部 head);进 attention core 前用 all-to-all 转成按 head 切(每卡全部 token、\(h/\mathrm{cp}\) head),本地算完整序列的 attention,再用一次 all-to-all 切回 sequence。两次 a2a 是分布式转置,全程每卡只持 \(1/\mathrm{cp}\) 数据、不复制。(Jacobs et al. 2023, Fig 2;arXiv:2309.14509)
4. causal mask 下的负载均衡(zigzag)¶
Megatron 的 get_pretrain_batch_on_this_cp_rank(utils.py:L2308)把序列切成 \(2\mathrm{cp}\) 个 chunk,每个 rank 取一前一后两块:
# 把 seq 维 reshape 成 [2*cp, s/(2*cp)],rank r 取 chunk[r] 和 chunk[2*cp-1-r]
index[0] = cp_rank                 # 前半的第 r 块
index[1] = 2 * cp_size - cp_rank - 1   # 后半的对称块
val = val.index_select(seq_dim, index)
以 CP=2 为例(注释见 utils.py:L2317):4 个 chunk 分配为 (chunk0, chunk3) → GPU0、(chunk1, chunk2) → GPU1。这样每个 rank 都同时持有「轻」块和「重」块,工作量大致相等。这就是文献中的 zigzag / load-balanced CP(Striped Attention 是另一种等价思路,arXiv:2311.09431)。
zigzag 是「按 seq 切」的 CP(ring 家族)特有的修正:causal 下每个 chunk 的计算量跟它在序列中的位置挂钩,一前一后配对才能拉平。Ulysses 按 head 切,各 rank 拿到的是完全同构的一份工作量,天然均衡,不需要这类修正(详见 02 第 3 节)。另外 zigzag 的配对成立有一个前提——切分对象是一条完整的 causal 序列;packed 序列里装着多条文档时,对整条做一次 zigzag 并不能保证每条文档内部均衡,这是 03 篇反复出现的出发点。
需要特别注意:CP 下 rank r 持有的 token 不是连续的一段,而是两块对称的 chunk。这会影响 RoPE 的 position id 计算、loss mask,以及与 PP/SP 切分的协调(详见 04)。
5. sequence packing:变长数据怎么进模型¶
01 到 03 会反复用到 sequence packing 这个概念,它是现代训练组织数据的基本事实,先在这里讲清楚,后面长文负载均衡的讨论才不会悬空。
真实语料的序列长度是长尾分布的(具体数字见 03 篇 §1.1)。最朴素的对齐方式是按 batch 内最长序列 padding:99% 短于 4K 的语料里混进一条 300K,整个 batch 都得按 300K 做 attention,算力大量烧在 pad token 上。sequence packing 的做法是把多条文档首尾相接,填满一条定长序列,padding 降到接近零。但拼接本身破坏了两个不变量,必须配套修复:
- attention 不能跨文档:mask 从整条序列的下三角变成 block-diagonal,每条文档只在自己内部做 causal attention;
- position id 逐文档重计:每条文档从 0 重新计数,否则 RoPE 会把拼接位置当成真实的远距离依赖。
Megatron 里先后有两代做法,刚好对应两种数据布局:
- BSHD 路径(pretrain 默认):GPT 数据集本来就把多条文档拼满
seq_length,文档边界由 eod token 标出;打开--reset-attention-mask/--reset-position-ids(arguments.py:L2945–L2950)后,dataloader 在 eod 处重置 attention mask 与 position id(get_ltor_masks_and_position_ids,common_utils.py:L337)。数据保持[b, s]的稠密布局,mask 是显式构造的。 - THD 路径(SFT 与长上下文):变长序列直接拼成一条 token 流,batch 维塌成
total_tokens,用cu_seqlens记录每条 sub-sequence 的边界,交给 TE / FlashAttention 的 varlen kernel——block-diagonal mask 不再显式物化,而由边界信息在 kernel 内隐式实现。THD 布局与PackedSeqParams的细节见 TP/SP 章 对 packed 格式的说明;Megatron 的 SFT dataset 就走这条路:逐条 conversation pack 进同一序列、position 逐条重计,并断言不再使用reset_position_ids(sft_dataset.py:L124)。
所以「packing 是不是现在 Megatron 训练的标准做法」的答案是肯定的,而且从来都是:pretrain 从 GPT 时代起就是「拼满定长序列、在 eod 处 reset mask」,SFT 与长上下文场景则换成了更彻底的 THD varlen 形态,03 篇会看到的 Megatron-LM Dynamic CP 同样以 packed THD 为前提。真正新的问题不在 packing 本身,而在 packed 之后 CP 怎么切:zigzag(§4)假设切分对象是一条从头到尾的 causal 序列,packed 序列里却装着多条文档;而且一条 packed 序列的 attention 工作量正比于各文档长度的平方和 \(\sum_j \ell_j^2\),而不是 \((\sum_j \ell_j)^2\)——「等 token 数」不再等于「等计算量」。这两个张力正是 03 篇长文负载均衡的全部出发点。
6. Megatron 的 CP 集成¶
有一个容易忽视但很重要的事实:Megatron core 自身并不实现 ring/a2a attention kernel。DotProductAttention(native)直接断言 context_parallel_size == 1(dot_product_attention.py:L57),CP 的实际 attention 计算由 TransformerEngine 的 TEDotProductAttention 完成(其内部实现了 ring / a2a / 分层三种方式)。Megatron 负责的是以下五件事:
- 切分:
get_batch_on_this_cp_rank把 batch 按 zigzag 切到各 CP rank(utils.py:L2369)。 - 传参:通过
pg_collection.cp(attention.py:L1237)把cp_group和cp_comm_type传给 TE;变长/packed 场景使用PackedSeqParams(携带cu_seqlens、cp_group)。 - 配置:
cp_comm_type(transformer_config.py:L891)选择 p2p / all_gather / a2a / a2a+p2p,可以逐层取不同值。 - group 构造:
parallel_state.py:L553建立 CP group;hierarchical_context_parallel_sizes建立分层 CP 的子 group。 - RoPE / position:由于 token 不连续,rotary embedding 要按 zigzag 后的真实 position 计算(
rope_utils.py中有 CP 分支)。
flowchart LR
    DATA["batch [b, s]"] -->|"get_batch_on_this_cp_rank\n(zigzag 切)"| LOCAL["本 rank: [b, s/cp]\n(两块对称 chunk)"]
    LOCAL --> ATTN["TEDotProductAttention\n(cp_group, cp_comm_type)"]
    ATTN -->|"ring / a2a / a2a+p2p\n(TE 内部)"| OUT["attn out [b, s/cp]"]
7. CP 在整个并行体系里的位置¶
有几个耦合点需要记住(04 会逐一展开):
- CP 与 DP 共享梯度规约域:参数梯度在
data_parallel_group(with_context_parallel=True)上 all-reduce(parallel_state.py:914, 1467)。因为 CP 各 rank 持有同一份权重、处理同一个样本的不同 token 段,它们的权重梯度要像 DP 一样求和。也就是说,CP 在梯度同步上的行为与 DP 一致,但在 forward 上切的是 sequence。 - CP 与 SP 都切 sequence:SP 在 TP 区外切 seq(\(s/\mathrm{TP}\)),CP 也切 seq(\(s/\mathrm{CP}\))。两者叠加时 token 被切成 \(s/(\mathrm{TP}\cdot\mathrm{CP})\),padding 要对齐到
tp·cp·2(context_parallel.py:L55,其中*2是为 zigzag 预留的)。 - CP 与 TP 正交:TP 切 head/hidden,CP 切 seq,两者可以同时开启。需要注意的是,Ulysses 的 a2a 同样按 head 切,会与 TP 的 head 切分共同消耗可用的 head 数(02 第 3 节)。
- CP 与 PP:PP 切层,中间 stage 的 batch 里非 metadata 字段为 None,CP 切分会自动跳过(
utils.py:L2350)。
8. 贯穿全文的数值示例¶
- 每卡持有
s/cp = 16K个 token 的 Q/K/V。 - Ring:每卡的 KV chunk 为
[16K, 64, 128]bf16,约 256 MB(K+V),沿环传cp-1=7步,每一步与上一步的 attention compute overlap。 - Ulysses:a2a 把
[16K, 64, 128]重排成[128K, 8, 128](每卡 8 个 head 的全序列),本地在 8 个 head 上计算128K²规模的 flash-attention。约束 CP=8 ≤ heads=64 满足。 - zigzag:每卡持有的不是连续的 16K,而是 chunk
r和 chunk15-r(共2*cp=16块,每块 8K)。
章节导览¶
| 文件 | 内容 | 对应代码 / 论文 |
|---|---|---|
README.md(本文) |
为什么需要 CP、统一抽象(Q-KV 二部任务图与 attention pool)、两大家族(Ring vs Ulysses)总览、zigzag 负载均衡、sequence packing 与变长数据的组织、Megatron 的接入方式、与 TP/SP/DP/PP 的耦合 | utils.py, transformer_config.py |
| 01 · Ring Attention | Ring Attention 深入:blockwise online softmax、KV 沿环 P2P、causal 负载不均与 zigzag/striped 修正、通信-计算 overlap、显存分析 | Ring Attention / Blockwise / Striped 论文 |
| 02 · DeepSpeed-Ulysses | DeepSpeed-Ulysses:用 all-to-all 在 sequence 切分与 head 切分之间转换、复杂度对比、head 数约束、a2a+p2p 分层 CP |
Ulysses 论文,mappings.py::_AllToAll |
| 03 · 长文负载均衡 | 长上下文训练的负载均衡:不均衡的三个维度(CP group 内 / CP group 间 / PP 维)、代价模型与 packing 的 Σℓ² 效应、按维度归类的八个工作(Libra、Skrull、WLB-LLM、FlexSP、Megatron-LM Dynamic CP、DCP、ChunkFlow、MagiAttention),Ulysses 按 head 切的均衡优势与 ring 的 zigzag 家族及其 dispatch 求解推广 | 八篇论文/博客的算法与伪代码 |
| 04 · Megatron-LM 实现 | Megatron 工程落地:get_batch_on_this_cp_rank 三条切分路径、CP group 构造(常规/分层/hybrid)、TE 传参与 per-microbatch 换组、RoPE 的 CP 处理、hybrid CP 调度器、与 SP/TP/PP 的协同 |
utils.py:L2308, attention.py, hybrid_cp_schedule.py |
cp_lab.ipynb |
纯 torch 手写 ring attention(online softmax + 真实 P2P)和 Ulysses(all-to-all)两条路径,CPU/gloo 本地多进程,逐元素对齐 full attention,并演示 zigzag 负载均衡 | —— |
建议按顺序阅读:本文先用统一抽象建立整体图景,01 深入 ring 这条路径(CP 的算法核心),02 介绍实现更直接的 Ulysses,03 跳出单一算法、以负载均衡的维度为线索调研长上下文训练的一批工作,04 落到 Megatron 的工程细节(含 dynamic CP 的代码对应),最后通过 lab 亲手实现两条路径。
参考代码¶
参考代码:megatron-lm:
utils.py:L2308——get_pretrain_batch_on_this_cp_rank:CP 的 zigzag 负载均衡切分transformer_config.py:L891——cp_comm_type(p2p / all_gather / a2a / a2a+p2p)dot_product_attention.py:L57—— native attention 断言CP==1:CP 的 ring/a2a 实现下沉到 TransformerEngineattention.py:L1237——cp_group=self.pg_collection.cp传给 TE attentionpacked_seq_params.py——PackedSeqParams携带cp_group/cu_seqlenshybrid_cp_schedule.py—— 变长序列的 balanced/dynamic CP 调度parallel_state.py:L553—— CP group 与hierarchical_context_parallel_sizes
讲完这些背景,接下来自然要深入 Ring 这条作为 CP 算法核心的路径:下一篇01 · Ring Attention会把 online softmax 的累加过程、KV 的环形 P2P、causal 负载均衡和通信-计算 overlap 一次讲清楚。