07 · linear 路线(二):衰减机制的演进¶
本篇沿一条主线展开:状态转移矩阵 \(A_t\) 如何参数化。从最简单的固定标量出发,依次走到数据相关标量、数据相关向量(通道级),每一步都在表达力与实现代价之间做交换。GLA 的通道级门带来的数值问题(\(1/\Gamma\) 溢出)会一直遗留到
09,直到 Kimi K3 才彻底解决。前置:
06的 chunkwise 三行公式(本篇每个机制都是它的一个变形)。统一记号见 Attention 机制 §2。论文:RetNet arXiv:2307.08621、Lightning Attention-2 arXiv:2401.04658 / MiniMax-01 arXiv:2501.08313、Mamba-2 arXiv:2405.21060、GLA arXiv:2312.06635。
0. 全谱系对照表¶
所有机制都是同一个递归的不同 \(G_t\)(GLA 论文 Table 1 的整理,转成本章列向量约定):
| 模型 | \(G_t\) 参数化 | 门的粒度 | 可学习参数 |
|---|---|---|---|
| 朴素 LA | \(\mathbf{1}\) | 无 | —— |
| RetNet | \(\gamma \cdot \mathbf{1}\mathbf{1}^{\top}\),\(\gamma\) 逐头固定 | 标量·数据无关 | 无(\(\gamma\) 是超参) |
| mLSTM | \(\gamma_t \mathbf{1}\mathbf{1}^{\top}\), \(\gamma_t = \sigma(x_t W_\gamma)\) | 标量·数据相关 | \(W_\gamma \in \mathbb{R}^{d \times 1}\) |
| Mamba-2 | \(\gamma_t \mathbf{1}\mathbf{1}^{\top}\), \(\gamma_t = \exp(-\mathrm{softplus}(x_t W_\gamma) \cdot e^{a})\) | 标量·数据相关 | \(W_\gamma \in \mathbb{R}^{d \times 1}\), \(a \in \mathbb{R}\) |
| Mamba(1) | \(\exp(-(\mathbf{1}^{\top} \alpha_t) \odot \exp(A))\), \(\alpha_t = \mathrm{softplus}(x_t W_{\alpha1} W_{\alpha2})\) | 矩阵(\(d_k \times d_v\) 全维) | \(A \in \mathbb{R}^{d_k \times d_v}\), 低秩 \(W_\alpha\) |
| HGRN-2 | \(\alpha_t^{\top} \mathbf{1}\), \(\alpha_t = \gamma + (1-\gamma)\,\sigma(x_t W_\alpha)\) | 通道 | \(W_\alpha\), \(\gamma \in (0,1)^{d_k}\) |
| RWKV-6 | \(\alpha_t^{\top} \mathbf{1}\), \(\alpha_t = \exp(-\exp(x_t W_\alpha))\) | 通道 | \(W_\alpha \in \mathbb{R}^{d \times d_k}\) |
| GLA | \(\alpha_t^{\top} \mathbf{1}\), \(\alpha_t = \sigma(x_t W_{\alpha1} W_{\alpha2})^{1/\tau}\) | 通道·数据相关 | \(W_{\alpha1} \in \mathbb{R}^{d \times 16}\), \(W_{\alpha2} \in \mathbb{R}^{16 \times d_k}\) |
| DFW | \(\alpha_t^{\top} \beta_t\)(外积,全秩) | 矩阵 | \(W_\alpha, W_\beta\) |
GLA 的选择介于标量与全矩阵之间:\(G_t = \alpha_t^{\top} \mathbf{1}\),秩 1 但只沿 \(d_k\) 变化,即对角门控。论文脚注提到他们尝试过 \(G_t = \alpha_t^{\top} \beta_t\)(DFW 式全秩外积),"resulted in only marginal improvements",因此选择了更简单的形式。超参:温度 \(\tau = 16\),低秩瓶颈维 16。
需要注意,RWKV-6 与 GLA 在数学上是同一个递归,只是门的参数化不同。
1. RetNet:固定衰减与多尺度¶
从状态空间出发 \(s_n = A s_{n-1} + K_n^{\top} v_n\),对角化 \(A = \Lambda(\gamma e^{i\theta})\Lambda^{-1}\),并把 \(\Lambda\) 吸收进 \(W_Q, W_K\)(Eq. 3):
把 \(\gamma\) 简化成标量(Eq. 4)后得到三种形式。
Parallel(Eq. 5):
\(D\) 同时编码了因果掩码和指数衰减——这是本章反复出现的模式(Mamba-2 称之为 1-SS 矩阵,GDN/KDA 称之为 \(\Gamma\))。
Recurrent(Eq. 6):\(S_n = \gamma S_{n-1} + K_n^{\top} V_n\),\(o_n = Q_n S_n\)。
def retnet_parallel(q, k, v, gamma, scale):
    """gamma: [H] 逐头固定衰减。"""
    T = q.shape[1]
    q, k, v = (x.transpose(1, 2) for x in (q, k, v))
    n = torch.arange(T, dtype=q.dtype, device=q.device)
    D = (gamma[:, None, None] ** (n[:, None] - n[None, :])).tril()        # [H,T,T]
    return ((((q * scale) @ k.transpose(-1, -2)) * D) @ v).transpose(1, 2)

# 实测:retnet_parallel(γ) == ssd_recurrent(g = log γ),rel_err = 3.9e-16 ✓
# —— RetNet 就是「g 与 t 无关」的 Mamba-2。
Multi-Scale Retention(MSR,Eq. 8)¶
γ = 1 − 2^{−5−arange(0,h)} ∈ ℝ^h                       ← 多尺度调度
head_i = Retention(X, γ_i)
Y = GroupNorm_h( Concat(head_1, …, head_h) )            ← 逐头归一化,必需
MSR(X) = ( swish(X W_G) ⊙ Y ) W_O                       ← output gate 的祖先
\(\gamma_i = 1 - 2^{-5-i}\):head 0 衰减最快(\(\gamma \approx 0.969\)),head \(h-1\) 最慢。每层共享同一组 \(\gamma\),且固定不学习。大模型实验中改用 \(\gamma = 1 - \exp(\mathrm{linspace}(\log 1/32, \log 1/512, h))\)。
为什么必须用 GroupNorm:各头 \(\gamma\) 不同,输出的方差统计随之不同,因此必须逐头归一化。这个 swish gate + GroupNorm 组合是后来所有 linear attention 的 output gate 的直接祖先(10 §3)。
三个利用 scale-invariance 的数值技巧(因为 \(\mathrm{GroupNorm}(\alpha \cdot \mathrm{head}) = \mathrm{GroupNorm}(\mathrm{head})\),这些缩放不改变结果,但能稳定数值流):\(QK^{\top}/\sqrt{d}\);\(\tilde{D}_{nm} = D_{nm} / \sqrt{\sum_i D_{ni}}\);\(\tilde{R}_{nm} = R_{nm} / \max(|\sum_i R_{ni}|, 1)\)。
参数分配:\(W_Q, W_K \in \mathbb{R}^{d \times d}\),\(W_G, W_V \in \mathbb{R}^{d \times 2d}\),\(W_O \in \mathbb{R}^{2d \times d}\)(retention 共 \(8d^2\));head dim q/k = 256、v = 512;FFN 中间维压到 \(2d\) 以对齐参数量。
RetNet 的局限就在「固定」二字上:\(\gamma\) 与输入无关,意味着没有 selection 机制(06 §4.5)。想让模型「根据内容决定忘多少」,就必须让 \(\gamma\) 变成 \(x_t\) 的函数。
2. Lightning Attention-2:left product 与 right product 分治¶
本节是纯实现视角,但它给出了理解 chunkwise 的另一个角度。
- Left product 指 \((QK^{\top})V\),先算 \(N \times N\),复杂度是二次的,但天然支持因果掩码。
- Right product 指 \(Q(K^{\top}V)\),先算 \(d \times d\),复杂度是线性的,但因果情形需要 cumsum,而 cumsum 串行、非 matmul,是效率瓶颈。
Lightning Attention-2 的答案是:intra-block 用 left product(块小,二次开销可忽略),inter-block 用 right product(用累积的 \(KV\)),从而完全绕开 cumsum。MiniMax-01 原文:
"The left product attention calculation is employed for intra-block operations, while the right product is utilized for inter-block operations. This division is crucial because the intra-blocks can be significantly reduced in size, thereby ensuring that the overall computational complexity remains linear."
这正是 06 §3.3 那个 chunkwise 公式的另一种命名:\(\mathrm{intra} = ((QK^{\top}) \odot M)\,V\) 是 left product,\(\mathrm{inter} = QS\) 是 right product。认出这个对应关系之后,Lightning Attention 就不需要单独学习了。
Algorithm 1(衰减率 \(\lambda\)、块大小 \(B\)):
M_ij = λ^{i−j} if i≥j else 0,   Λ = diag{λ⁰, λ¹, …, λ^{B−1}},   KV = 0

for i in 1..T/B:
    O_intra = [ (Q_i K_iᵀ) ⊙ M ] V_i                 # left product
    O_inter = Λ Q_i (KV)                              # right product
    KV     ← λ^B KV + (λ^B Λ⁻¹ K_i)ᵀ V_i
    O_i    = O_intra + O_inter
⚠️ 原文 Algorithm 1 写 \(\Lambda = \mathrm{diag}\{\lambda, \lambda^2, \dots, \lambda^B\}\),而推导部分写 \(\Lambda = \mathrm{diag}\{1, \lambda, \dots, \lambda^{B-1}\}\),两者差一个全局 \(\lambda\) 因子,取决于块内位置是 0- 还是 1-indexed。实现时用 \(\Lambda_{rr} = \lambda^r\)(\(r = 0, \dots, B-1\))与 \(M_{ij} = \lambda^{i-j}\) 配套即可自洽。
MiniMax-01 的配置¶
这是 linear attention 第一次上到 456B 规模。
- 7:1 hybrid:每 7 个 lightning attention block 后接 1 个 softmax attention block;总 80 层
- 每个 attention 模块 64 头 × head dim 128;softmax 层用 GQA-8
- RoPE 只施加于 head dim 的一半,base = 10000
- hidden 6144;每层 32 experts top-2;总 456B / 激活 45.9B
- PostNorm(DeepNorm)优于 PreNorm —— 因为 hybrid 下「有效深度」很重要,PreNorm 会缩短有效深度
FLOPs 对照(原文):
| 类型 | FLOPs |
|---|---|
| Softmax Attention | \(72bn\ell d^2(1 + n/(6d) + 5/(18d))\) |
| Lightning Attention | \(72bn\ell d^2(1 + 1/(2h) + 5/(18d))\) |
| Hybrid-lightning | \(72bn\ell d^2(1 + n/(48d) + 7/(16h) + 5/(18d))\) |
注意 hybrid 的 \(n/(48d)\) 项恰好是全 softmax 的 \(n/(6d)\) 的 1/8——正是 1/8 的层保留了二次项。这是「层混合比例直接出现在 FLOPs 公式里」的一个干净例子。
3. Mamba-2 / SSD:标量衰减与半可分离矩阵¶
Mamba-2 的递归本身很简单;它的价值在于提供了一个全新的看待方式。
3.1 SSD 层¶
从 selective SSM 出发做两处简化(§2.4):第一,\(A\) 从对角进一步简化为标量乘单位阵(\(A_t = a_t I\));第二,head dim 从 Mamba-1 的 1 提升到 {64, 128}。
对应到 linear attention 时,\(B\) 对应 \(K\)、\(C\) 对应 \(Q\)、\(X\) 对应 \(V\)、\(a_t\) 对应标量衰减:
3.2 Dual(二次)形式:衰减即位置编码¶
与 softmax attention 的差别只有两点(原文):一是丢掉 softmax;二是 attention 矩阵额外逐元素乘一个掩码矩阵 \(L\)(原文把这个掩码矩阵记作 \(L\);本文序列长统一记作 \(N\),二者不是一个东西,本节下文沿用原文的 \(L\))。作者的解读非常重要:
"the mask matrix \(L\) can be viewed as replacing the heuristic positional embeddings of Transformers with a different data-dependent positional mask that controls how much information is transferred across time."
「衰减即数据相关的位置编码」这个观点后来被 Kimi Linear §6.1 大幅扩展,并直接支撑了「MLA 层可以用 NoPE」这个决定(09 §4)。
3.3 半可分离矩阵¶
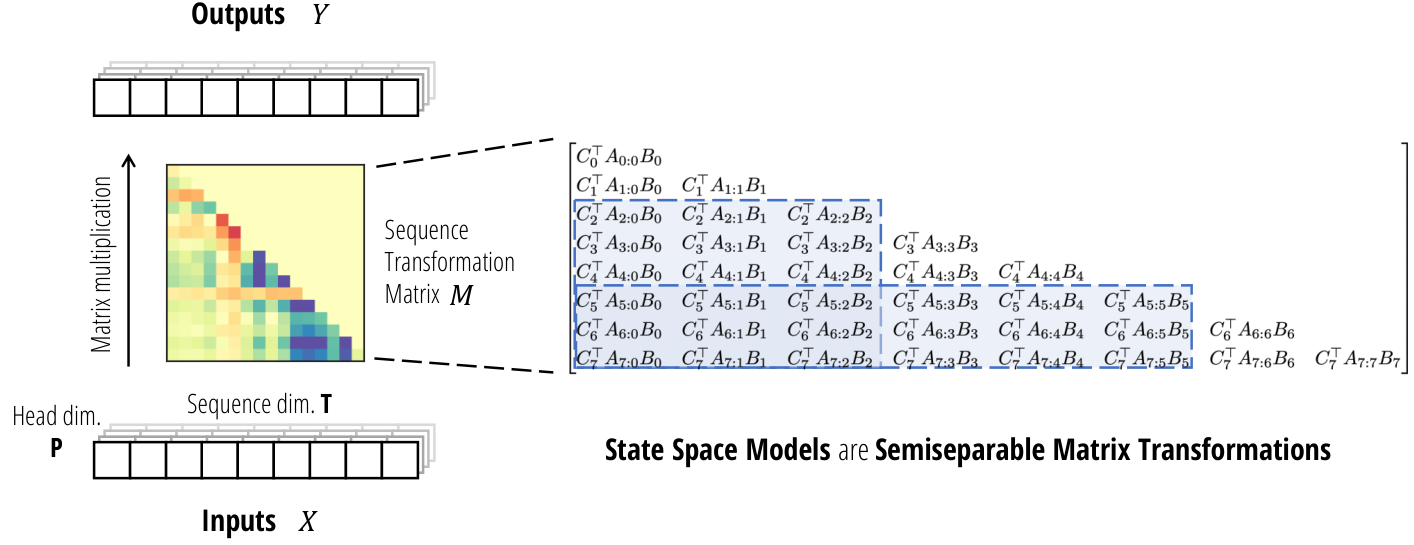
图:SSM = 半可分离矩阵(Dao & Gu 2024, Fig 2;arXiv:2405.21060)。右半边是全部信息量所在:\(M\) 的下三角部分里,任取一个不跨对角线的子矩阵,它的秩最多是 \(N\)。这个「低秩」性质就是 chunkwise 算法里 inter-chunk 项之所以能用一个 \(d \times d\) 状态概括的结构性原因。
Definition 3.1:下三角矩阵 \(M\) 是 \(N\)-semiseparable 的,当且仅当其下三角部分(含对角)内的任意子矩阵秩至多为 \(N\)。
Definition 3.2(SSS 表示):\(M_{ji} = C_j^{\top} A_{j:i} B_i\),其中 \(A_{j:i} := A_j A_{j-1} \cdots A_{i+1}\)。
Lemma 3.3 的证明只需看任意 off-diagonal block(\(j' > j \ge i > i'\))有显式秩-\(N\) 分解(Eq. 5):
Theorem 3.5:SSM 变换 \(y = \mathrm{SSM}(A,B,C)(x)\)(状态维 \(N\))等同于乘以一个 SSS 表示的 \(N\)-SS 矩阵。
1-SS 矩阵:标量 SSM(\(N=1\),无 \(B, C\))对应 \(M_{ji} = a_{j:i}\),\(y = Mx\) 就是 \(y_t = a_t y_{t-1} + x_t\)。作者称之为 cumprodsum 算子,即 cumprod 与 cumsum 的推广。Mamba-2 的 \(L\) 掩码就是一个 1-SS 矩阵。
"1-SS matrices exemplify this connection: there are many fast algorithms for computing the primitive scalar recurrence or cumprodsum operator, and all of them turn out to be equivalent to different structured factorization of 1-SS matrices."
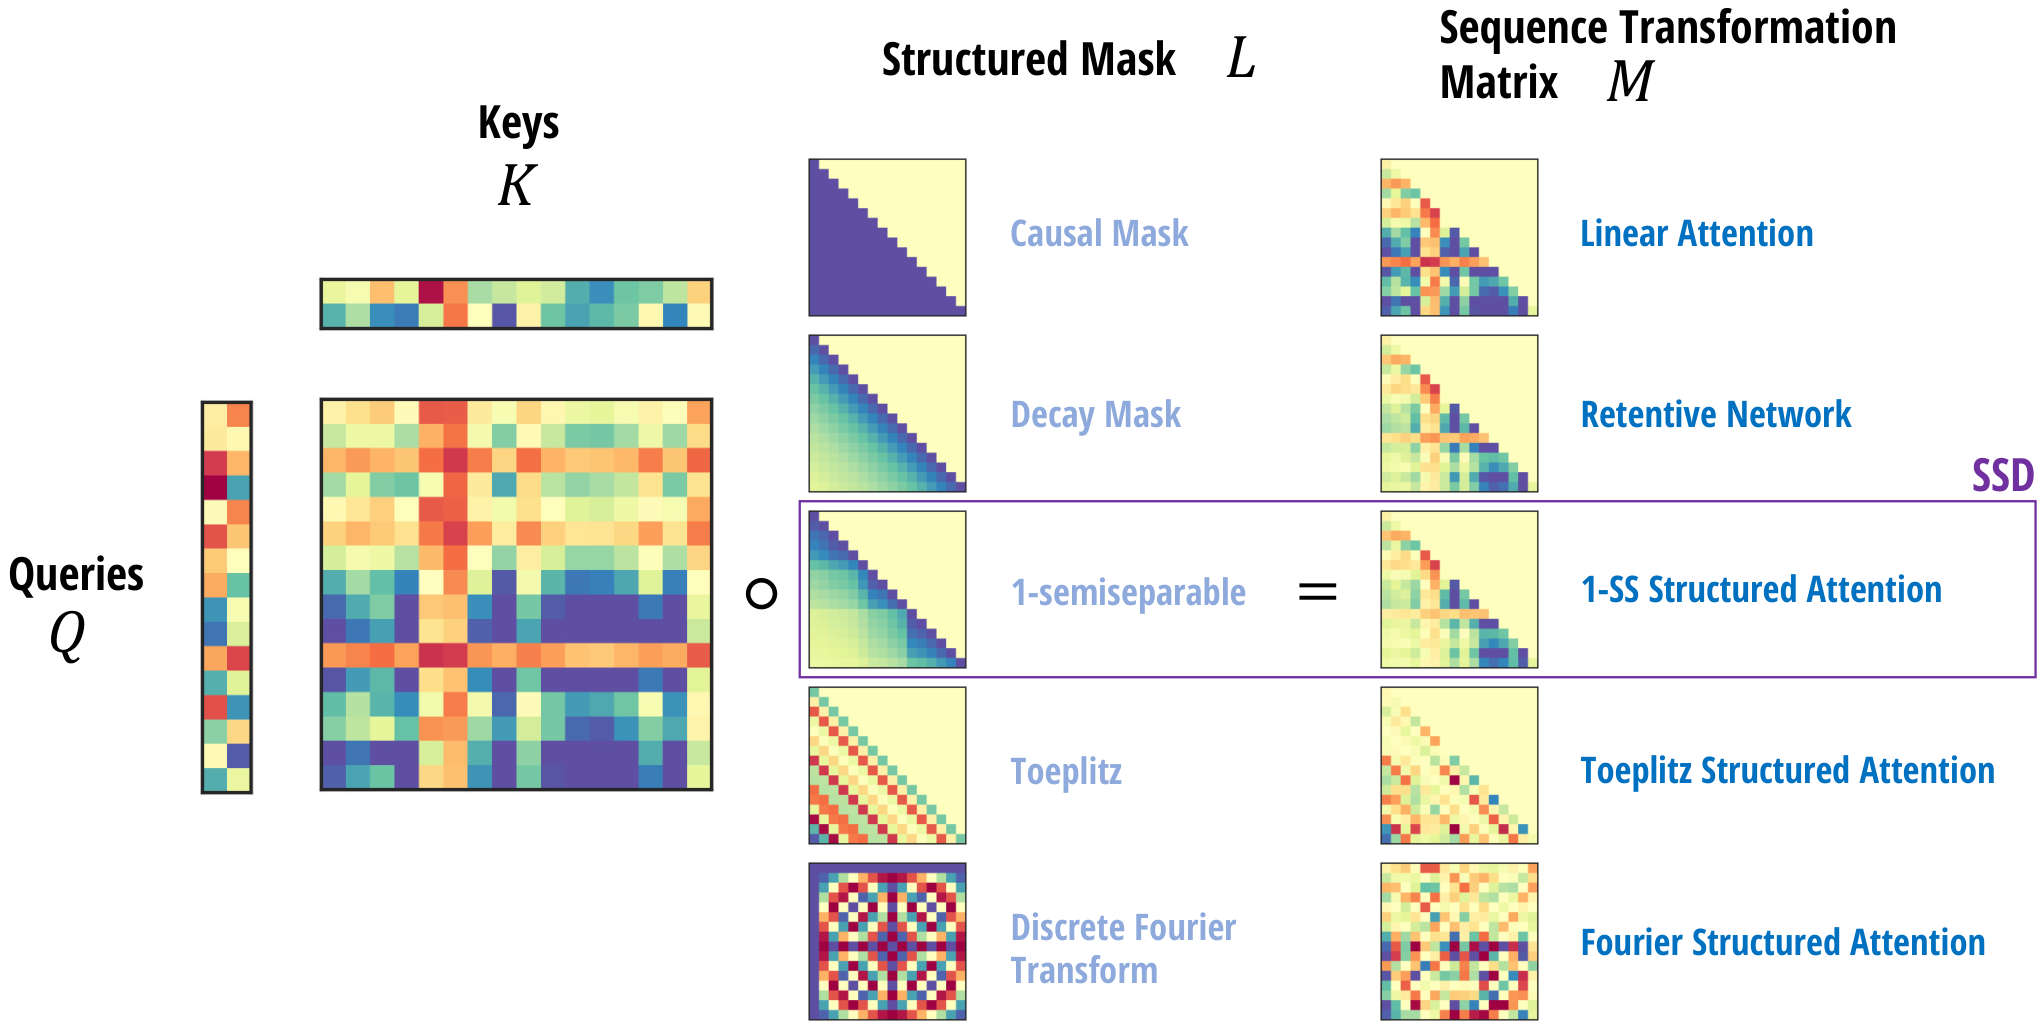
图:SMA 框架(Dao & Gu 2024, Fig 3;arXiv:2405.21060)。这张图把 linear attention、RetNet、SSD 统一到了同一个框架里:只要 \(L\) 是「有快速算法的结构化矩阵」,\((QK^{\top} \circ L)\,V\) 就有次二次算法。Linear Attention 对应 \(L\) = 全 1 下三角,RetNet 对应 \(L_{ij} = \gamma^{i-j}\),SSD 对应 \(L\) = 1-semiseparable。缩并顺序的不同就是
06§3 里 parallel/recurrent 的区别。
原文关于 RetNet 的定位也在这里:"RetNet and TransNormerLLM generalize Linear Attention using decay terms… These algorithms can be seen as an instantiation of SSD where \(A_t\) is time-invariant; in the SMA interpretation, the mask matrix \(L\) would be a decay matrix \(L_{i,j} = \gamma^{i-j}\)."
3.4 SSD 算法:块分解¶
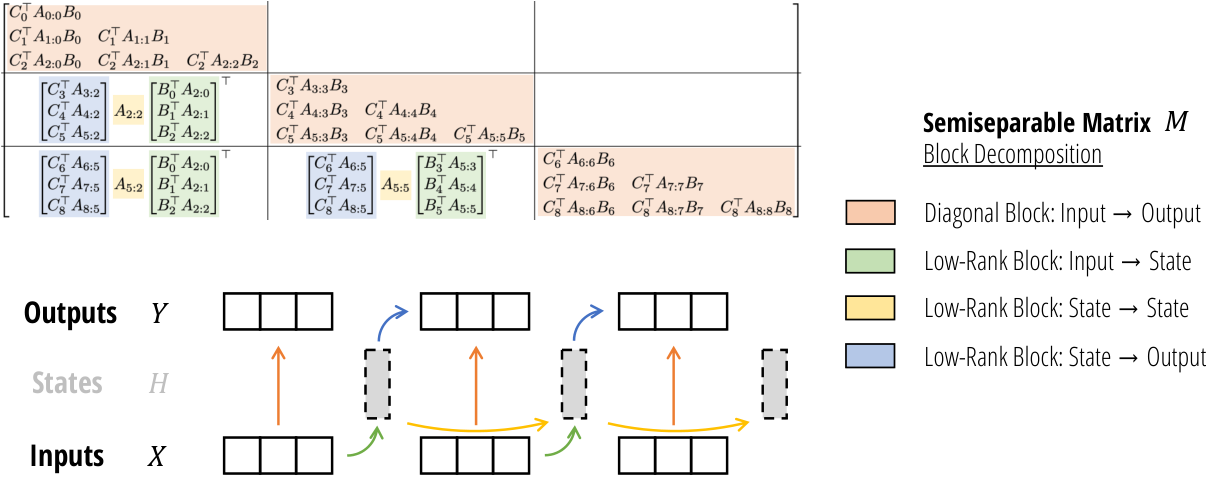
图:SSD 的核心算法图(Dao & Gu 2024, Fig 5;arXiv:2405.21060)。它既是一个矩阵乘法的分块算法,也是 SSM 的 chunk 视图——这个双重身份是 SSD 全部优雅之处。橙色对角块 = intra-chunk(用二次形式算,小 \(Q\) 时更快,且所有 chunk 可并行);绿色非对角块 = inter-chunk(秩 \(\le N\),归约成一个更小的递归)。对照
06§3.3 那三行 chunkwise 公式:对角块就是 \(((QK^{\top}) \odot M)\,V\),非对角块就是 \(QS\)。
整个算法分四步(对应 Eq. 5 分解的三个因子):
- 对角块(intra-chunk 输出):假设 chunk 初始状态为 0,算块内贡献。
- 右 \(B\)-因子(chunk 内状态):\((N,Q) \times (Q,P)\) matmul,每个 chunk 得到一个 \((N,P)\) 矩阵。含义:「假设 chunk 初始状态为 0 时,本 chunk 的最终状态」。
- 中心 \(A\)-因子(chunk 间递归):把 per-chunk 终态乘以由 \(A^{\times}\) 生成的 1-SS 矩阵。含义:「考虑全部历史后的真实 chunk 边界状态」。
- 左 \(C\)-因子(state→output):\(\mathrm{contract}(QN, NP \to QP)\)。含义:「只考虑先前输入、本 chunk 输入置零时的输出」。
最终 \(Y\) 为步骤 1 与步骤 4 之和。最优配置是 \(N = P = Q\)(状态维 = head 维 = chunk 长),此时所有 BMM 都变成 \(\mathrm{BMM}(T/N, N, N, N)\)。
3.5 代码:dual、chunkwise 与 recurrent 的等价¶
def ssd_recurrent(q, k, v, g, scale):
    """g: [B,T,H] 对数标量衰减 (log a_t)。"""
    B, T, H, K = q.shape
    S = q.new_zeros(B, H, K, v.shape[-1]); o = torch.zeros_like(v)
    for t in range(T):
        S = S * g[:, t].exp()[..., None, None] + k[:, t].unsqueeze(-1) * v[:, t].unsqueeze(-2)
        o[:, t] = torch.einsum('bhk,bhkv->bhv', q[:, t] * scale, S)
    return o

def ssd_dual(q, k, v, g, scale):
    """二次 dual 形式:(QK^T ⊙ L)V,L 是 1-semiseparable 衰减掩码。"""
    q, k, v, g = (x.transpose(1, 2) for x in (q, k, v, g))
    gc = g.cumsum(-1)                                                     # [B,H,T]
    L = (gc[..., :, None] - gc[..., None, :]).tril().exp().tril()          # L_ij = prod_{j<s<=i} a_s
    return ((((q * scale) @ k.transpose(-1, -2)) * L) @ v).transpose(1, 2)

def ssd_chunk(q, k, v, g, scale, C):
    B, T, H, K = q.shape
    V, NT = v.shape[-1], T // C
    qc, kc, vc = (x.transpose(1, 2).reshape(B, H, NT, C, -1) for x in (q, k, v))
    gc = g.transpose(1, 2).reshape(B, H, NT, C).cumsum(-1)     # ← 【局部】cumsum,每 chunk 重新开始
    S = q.new_zeros(B, H, K, V); o = torch.zeros_like(vc)
    M = torch.ones(C, C, dtype=torch.bool, device=q.device).tril()
    for n in range(NT):
        qi, ki, vi, gi = qc[:, :, n] * scale, kc[:, :, n], vc[:, :, n], gc[:, :, n]
        L = (gi[..., :, None] - gi[..., None, :]).exp() * M                # 块内衰减
        intra = ((qi @ ki.transpose(-1, -2)) * L) @ vi
        inter = (qi * gi[..., None].exp()) @ S                             # q 衰减回 chunk 起点
        o[:, :, n] = inter + intra
        g_last = gi[:, :, -1:]
        S = S * g_last[..., None].exp() + \
            (ki * (g_last - gi)[..., None].exp()).transpose(-1, -2) @ vi   # k 衰减到 chunk 末
    return o.reshape(B, H, T, V).transpose(1, 2)

# 实测(float64, C=16):
#   rel_err(ssd_dual,  ssd_recurrent) = 9.0e-16
#   rel_err(ssd_chunk, ssd_recurrent) = 3.3e-16     ✓
三个关键实现点在后面的每个机制中都一样:
- cumsum 必须是局部的(每 chunk 从 0 重新累积)。全局 cumsum 在长序列下会下溢到 0。
- \(\exp(g_i - g_j)\) 是差分,不是连乘。 \(g\) 已是对数域的局部 cumsum,所以一次减法加一次
exp就给出正确的 \(\gamma^{j \to i}\)——fla的 kernel 里就是这一行(06 · Flash Linear Attention §3)。 - 三处衰减的方向不同:
inter项把q衰减回 chunk 起点;状态更新里S整体乘 \(\gamma^C\),而k衰减到 chunk 末尾。方向搞混不会报错,只会静默算错。
性能:比 Mamba-1 的 selective scan 快 2–8 倍,支持 8 倍更大的状态;与 FlashAttention-2 相比在 seqlen 2K 处交叉、16K 处快 6 倍。
4. GLA:通道级门控及其数值问题¶
4.1 递归¶
与 Mamba-2 的唯一差别是把标量 \(a_t\) 换成向量 \(\alpha_t \in (0,1)^{d_k}\)。每个 key 通道有自己的遗忘速率,状态的不同行可以以不同速度衰减,表达力更强。参数化用低秩瓶颈(从 \(d\) 压缩到 16 再映射到 \(d_k\))保证参数量不失控。
4.2 并行形式与数值不稳定¶
展开递归,令 \(b_t := \prod_{j \le t} \alpha_j\)(累积衰减):
⚠️ \(b_t\) 是 \((0,1)\) 区间数的累积乘积,\(t\) 大时极小,因此 \(K/B\) 会爆炸。对策是在 log 空间计算(Eq. 4):
但这不是标准 matmul,无法使用半精度 tensor core。这是 GLA 整篇论文最大的工程负担。
4.3 Chunkwise:三种块内衰减¶
定义(chunk \(i\)、块内位置 \(j\)):
原文的直觉:\(\Lambda\) 编码「从 chunk 起点起的累积衰减,用于传播上一 chunk 的状态」;\(\Gamma\) 编码「到 chunk 终点的衰减,用于累积到下一 chunk 状态」。
def gla_chunk(q, k, v, g, scale, C):
    """g: [B,T,H,K] 对数【通道级】衰减。"""
    B, T, H, K = q.shape
    V, NT = v.shape[-1], T // C
    qc, kc, vc = (x.transpose(1, 2).reshape(B, H, NT, C, -1) for x in (q, k, v))
    gc = g.transpose(1, 2).reshape(B, H, NT, C, K).cumsum(-2)              # [B,H,NT,C,K] 局部 cumsum
    S = q.new_zeros(B, H, K, V); o = torch.zeros_like(vc)
    M = torch.ones(C, C, dtype=torch.bool, device=q.device).tril()
    for n in range(NT):
        qi, ki, vi, gi = qc[:, :, n] * scale, kc[:, :, n], vc[:, :, n], gc[:, :, n]
        # intra: A_ij = Σ_d q_id k_jd exp(g_id − g_jd)  —— 因为衰减带 d 下标,这【不能】写成单次 matmul
        A = torch.zeros(B, H, C, C, dtype=q.dtype, device=q.device)
        for j in range(C):                                                 # ← 这个循环就是「二级分块」的根源
            A[..., j] = ((qi * (gi - gi[..., j:j+1, :]).exp()) * ki[..., j:j+1, :]).sum(-1)
        o[:, :, n] = (qi * gi.exp()) @ S + (A * M) @ vi
        g_last = gi[:, :, -1:]                                             # [B,H,1,K]
        S = S * g_last.transpose(-1, -2).exp() + \
            (ki * (g_last - gi).exp()).transpose(-1, -2) @ vi
    return o.reshape(B, H, T, V).transpose(1, 2)

# 实测(float64, C=16):rel_err(gla_chunk, gla_recurrent) = 3.2e-16 ✓
注意那个 for j in range(C) 循环。 Mamba-2 里 \(L = \exp(g_i - g_j)\) 是一个 \([C, C]\) 矩阵,可以直接逐元素乘到 \(QK^{\top}\) 上;GLA 里衰减带 \(d\) 下标,\(\exp(g_{id} - g_{jd})\) 是一个 \([C, C, d]\) 张量,不能提到 matmul 外面。这就是「通道级门控的代价」,它具体化成了一个串行循环。
4.4 二级分块(secondary-level chunking)¶
二级分块是 GLA 最重要的工程贡献,也是 KDA 后来要消除的东西。
问题:intra-chunk 的 \(A\) 必须在 log 空间全精度计算,无法使用 tensor core。 方案:把 chunk 再切成 sub-chunk(GLA 与 Kimi Linear 都用 16),sub-chunk 之间用半精度 matmul:
sub-chunk 内部(对角块)仍用 Eq. 4 逐位置对全精度计算。
三层结构(Fig 3):
| level | 内容 | tensor core |
|---|---|---|
| 1(chunk 间) | 用累积状态 \(S\) | ✓ |
| 2(sub-chunk 间,橙色块) | 半精度 matmul | ✓ |
| 2(sub-chunk 内,粉色块) | 全精度 log 空间,逐位置对 | ✗ |
fla 里这三块对应三个 kernel:chunk_gla_fwd_A_kernel_intra_sub_inter(sub-chunk 对 \(i > j\))、..._intra_sub_intra(对角)、chunk.py:L209(大 \(K\) 时的切分)。
代价有实测数据:fla 的 GB200 benchmark 里 chunk_gla 一贯比 chunk_retention / chunk_simple_gla 慢 1.4–2.3 倍——这正是通道级门控带来的开销(06 · Flash Linear Attention §9)。
4.5 省内存的 dα_t¶
此前工作(Mamba)声称必须物化 \(N \times d \times d\) 的 hidden states 才能算 \(d\alpha_t = (S_{t-1} \odot dS_t)\,\mathbf{1}\)。GLA 给出闭式:
对 Eq. 4 求导即可得到。这就是为什么 fla 的 dg 是在 chunk_bwd_kernel_dqkwg 里顺带累加的(而不是单独算一遍),见 06 · Flash Linear Attention §7。
4.6 GLA Transformer 的完整层¶
S^h_t = ((α^h_t)ᵀ 1) ⊙ S^h_{t-1} + k^h_t (v^h_t)ᵀ            S^h ∈ ℝ^{d'_k × d'_v}
o^h_t = (S^h_t)ᵀ q^h_t
o'_t  = concat( LN(o^1_t), …, LN(o^H_t) )                     ← 逐头 LayerNorm
r_t   = Swish(x_t W_r + b_r)                                   ← output gate
y_t   = (r_t ⊙ o'_t) W_O
Block 结构为 \(\mathrm{GLA}(\mathrm{LN}(X)) + X\),然后接 \(\mathrm{SwiGLU}(\mathrm{LN}(Y)) + X\)。这个「逐头 norm + output gate」的结构从 RetNet 传下来,一直传到 KDA(10)。
5. 小结¶
| 机制 | 转移 \(A_t\) | 表达力 | 实现代价 |
|---|---|---|---|
| 朴素 LA | \(I\) | 最弱:无遗忘 | 最简单 |
| RetNet | \(\gamma I\),固定逐头 | 有衰减但无 selection | 最简单,\(D\) 可预计算 |
| Lightning Attn-2 | \(\lambda I\),固定 | 同 RetNet | left/right product 分治,绕开 cumsum |
| Mamba-2 / SSD | \(a_t I\),数据相关标量 | 有 selection(标量粒度) | 干净:\(L\) 是 \([C, C]\) 矩阵,可直接逐元素乘 |
| GLA / RWKV-6 | \(\mathrm{Diag}(\alpha_t)\),数据相关向量 | 通道级 selection | \(1/\Gamma\) 溢出 ⇒ 二级分块 ⇒ 部分路径丢掉 tensor core,慢 1.4–2.3× |
这条路线到 GLA 已经把「对角转移矩阵」做到了头。再想提升表达力就必须离开对角;但另一个方向的问题始终没解决:衰减只会「按比例淡忘一切」,无法「精确替换某一个 key 对应的 value」。
举一个具体例子说明这个区别有多重要:序列里先出现 "the capital of France is Paris"、后出现 "actually, the capital of France is Lyon"。衰减机制只能让前者整体变淡(连带把别的记忆也淡化),而理想的操作是只擦除 k="capital of France" 这一条的旧 value、写入新 value,其他记忆完全不动。
这需要一个完全不同的更新规则。
下一篇:08 · linear 路线(三):delta rule 与 DPLR 统一框架 —— delta rule:把 linear attention 的状态看成一个在推理时被在线训练的回归模型,于是「精确替换」变成了一步梯度下降。这一篇会给出 DPLR 统一框架,把本篇和下篇的所有机制装进同一个循环。